4.5_策略梯度定理

在这个选修部分中,我们将研究如何我们将对用于近似策略梯度的目标函数进行微分。

让我们首先回顾一下我们的不同公式:

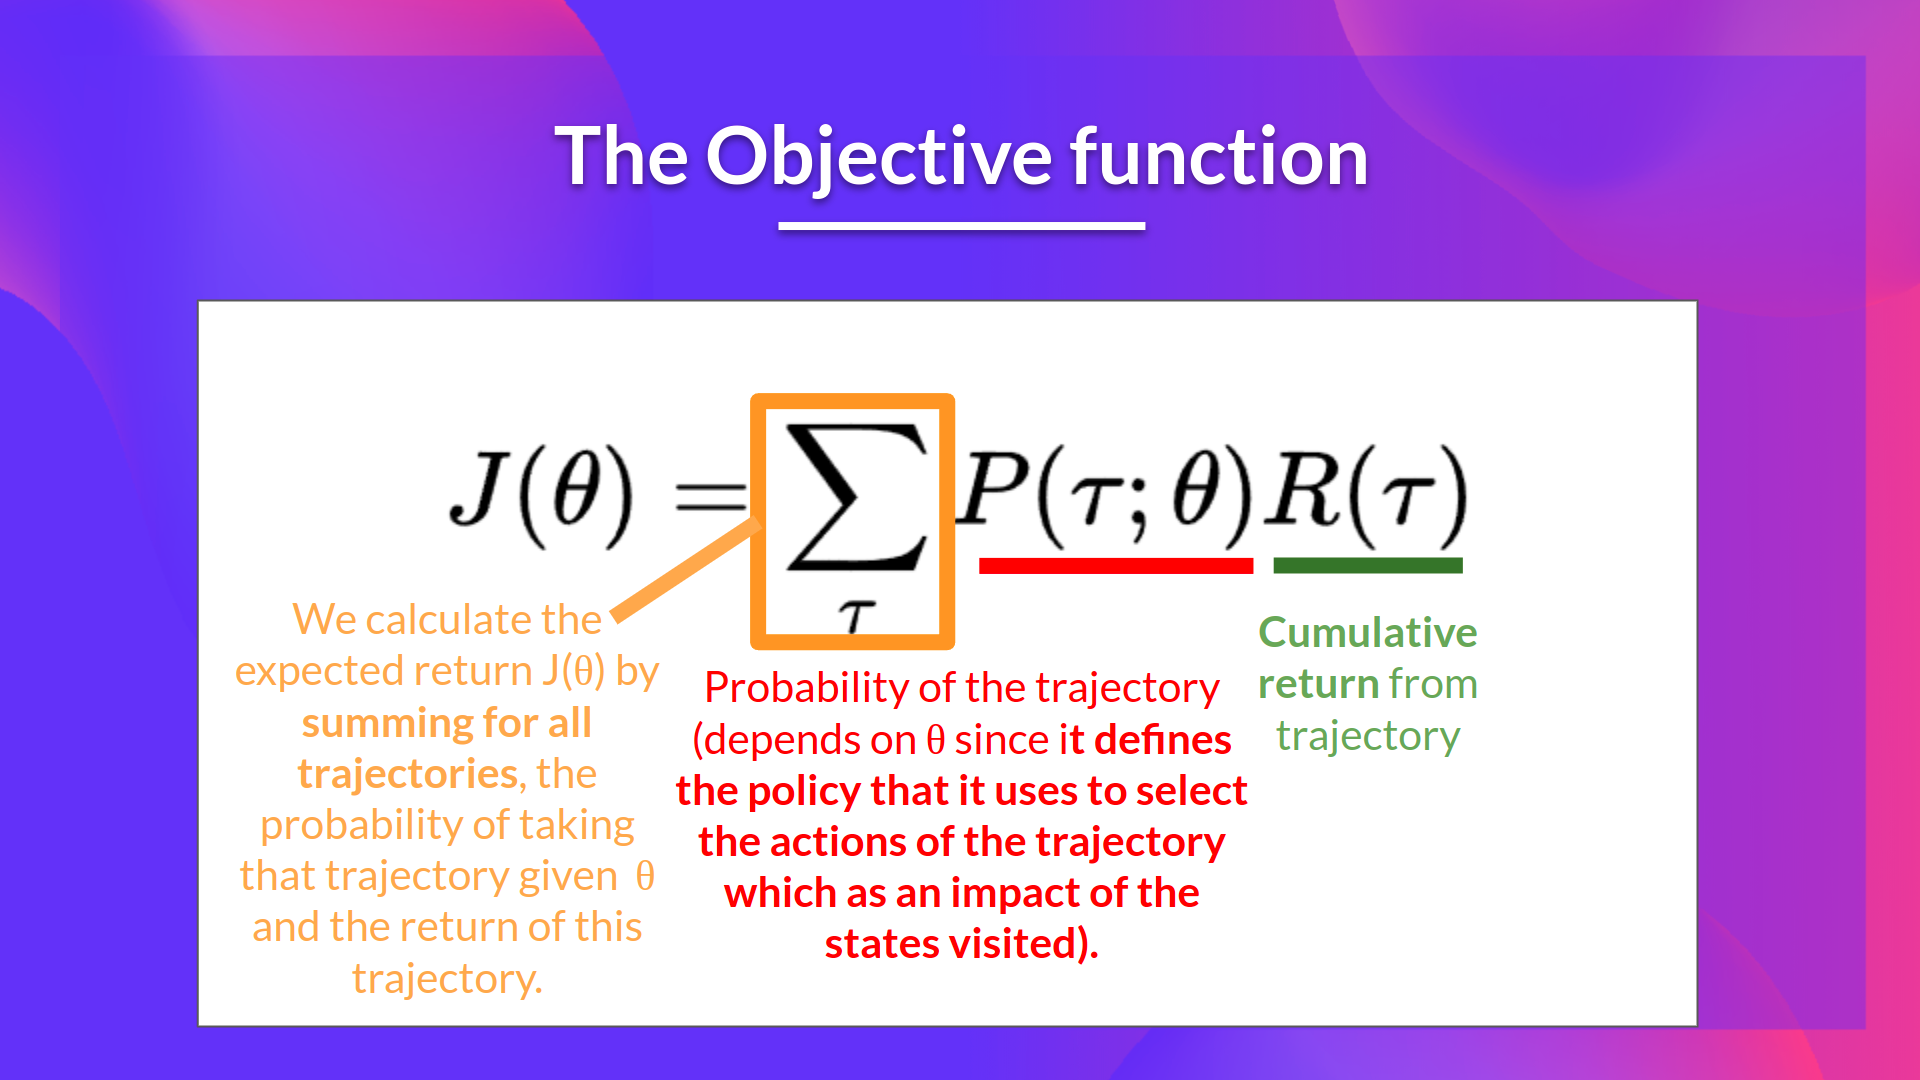
  1. 目标函数
Return
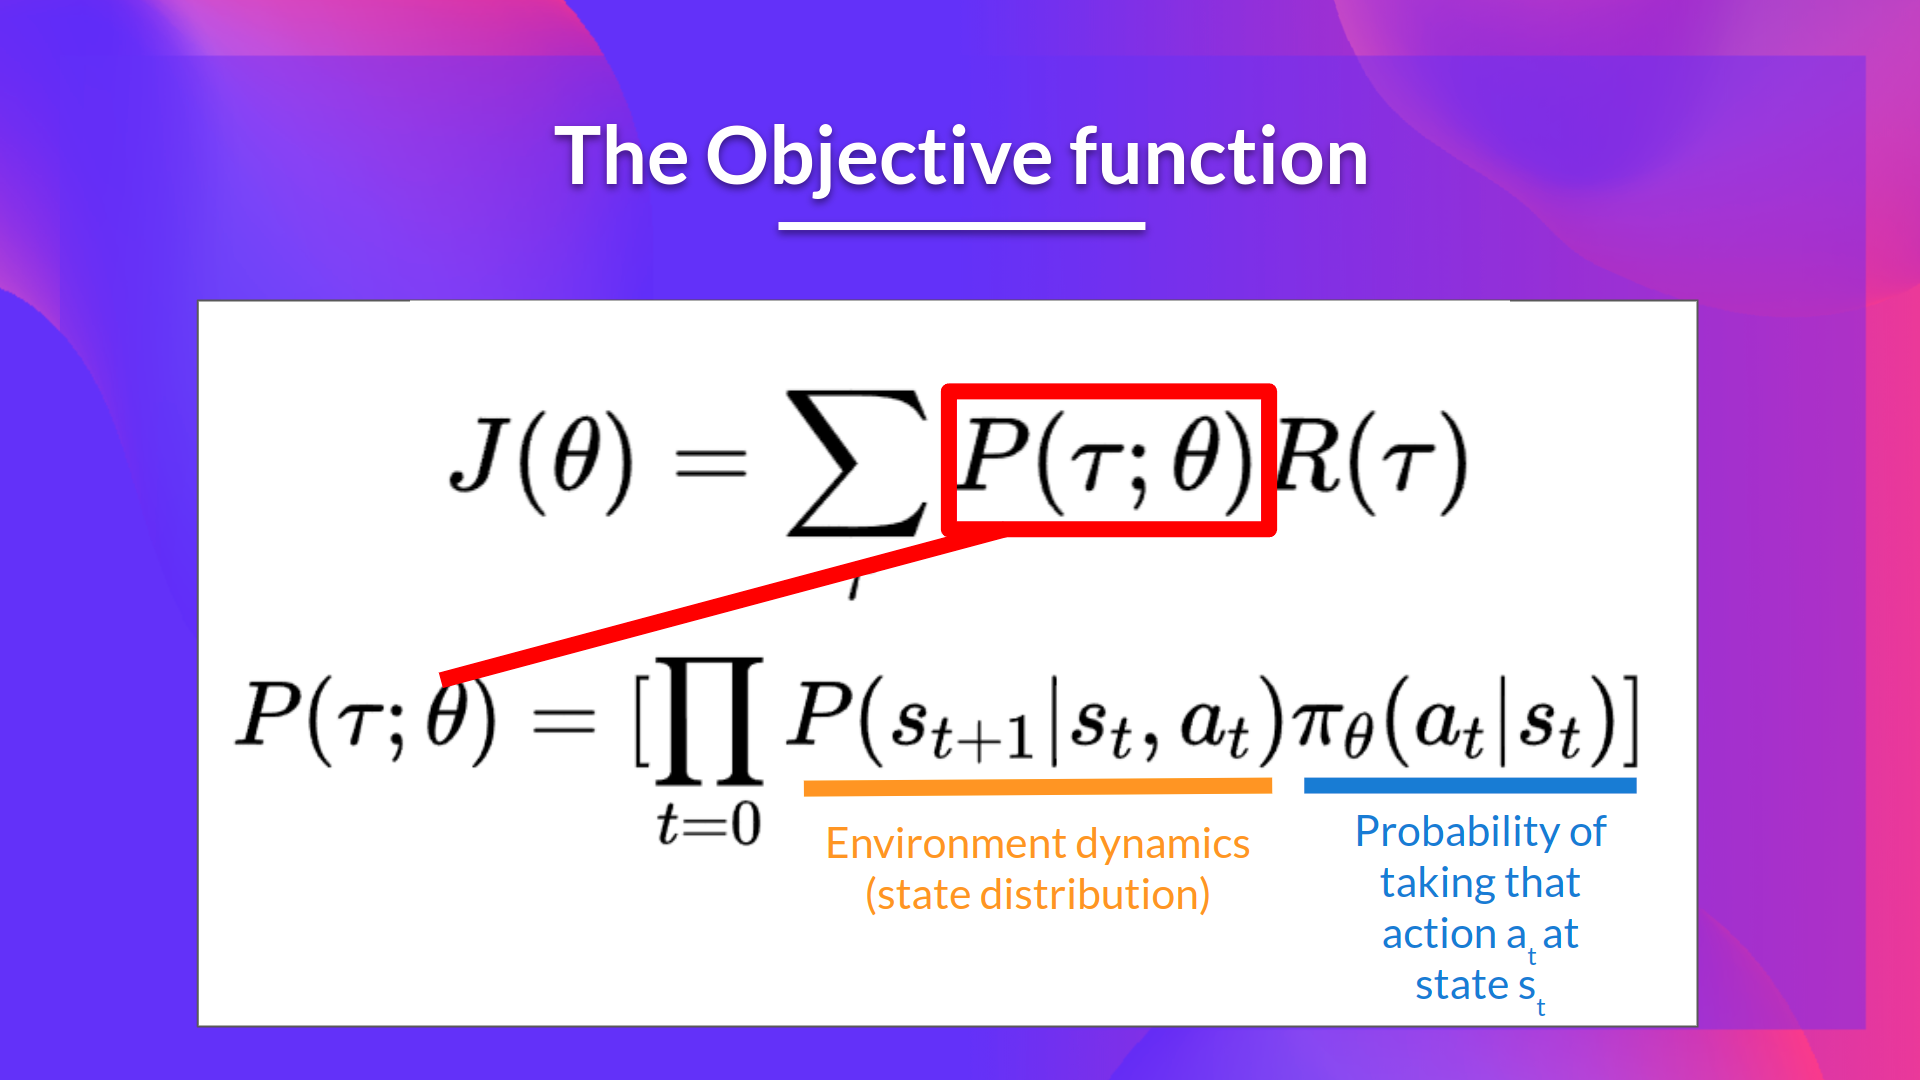
  1. 轨迹的概率(给定来自 \(\pi_\theta\) 的动作):
Probability

所以我们有:

(∇θJ(θ)=∇θ∑τP(τ;θ)R(τ))

我们可以将求和的梯度重写为梯度求和:

(=∑τ∇θP(τ;θ)R(τ))然后我们将总和中的每一项乘以(P(τ;θ)P(τ;θ)(这是可能的,因为它=1)(=∑τP(τ;θ)P(τ;θ)∇θP(τ;θ)R(τ))我们可以进一步简化这个因为(P(τ;θ)P(τ;θ)∇θP(τ;θ)=P(τ;θ)∇θP(τ;θ)P(τ;θ))(=∑τP(τ;θ)∇θP(τ;θ)P(τ;θ)R(τ))

接着我们可以运用“对数求导技巧”(也称“似然比技巧”或“REINFORCE技巧”),
这是微积分中的一个简单规则,它意味着 $$\( \nabla_x log f(x) = \frac{\nabla_x f(x)}{f(x)} \)

$$因此,对于我们已有的(∇θP(τ;θ)P(τ;θ)),我们将其转化为(∇θlogP(τ|θ))

因此,这就是我们的似然策略梯度:

(∇θJ(θ)=∑τP(τ;θ)∇θlogP(τ;θ)R(τ))

感谢这个新公式,我们可以使用轨迹样本来估计梯度(如果你愿意,我们可以使用基于样本的估计来近似似然比策略梯度)

(∇θJ(θ)=1m∑i=1m∇θlog⁡P(τ(i);θ)R(τ(i))),其中每个(τ(i))都是一个采样的轨迹。

但是我们还有一些数学工作要做:我们需要简化 \( \nabla_\theta log P(\tau|\theta) \)

我们知道:

(∇θlogP(τ(i);θ)=∇θlog[μ(s0)∏t=0HP(st+1(i)|st(i),at(i))πθ(at(i)|st(i))])这里的(μ(s0))是初始状态分布,(P(st+1(i)|st(i),at(i)))是MDP的状态转移动力学。

我们知道一个对数的乘积等于两个对数之和:

(∇θlogP(τ(i);θ)=∇θ[logμ(s0)+∑t=0HlogP(st+1(i)|st(i)at(i))+∑t=0Hlogπθ(at(i)|st(i))])

我们也知道和的梯度等于梯度的和:

(∇θlogP(τ(i);θ)=∇θlogμ(s0)+∇θ∑t=0HlogP(st+1(i)|st(i)at(i))+∇θ∑t=0Hlogπθ(at(i)|st(i)))

由于 MDP 的初始状态分布或状态转换动力学都不依赖于 \(\theta\) ,两项的导数都是 0。因此我们可以移除它们:

因此:

(∇θ∑t=0HlogP(st+1(i)|st(i)at(i))=0)and(∇θμ(s0)=0)(∇θlogP(τ(i);θ)=∇θ∑t=0Hlogπθ(at(i)|st(i)))

我们可以将求和的梯度重写为梯度求和:

(∇θlogP(τ(i);θ)=∑t=0H∇θlogπθ(at(i)|st(i)))因此,估计策略梯度的最终公式为:(∇θJ(θ)=g^=1m∑i=1m∑t=0H∇θlog⁡πθ(at(i)|st(i))R(τ(i)))